百度智能云VectorDB benchmark测试方法
- AIGC
- 2025-07-30
- 714热度
- 0评论
测试方法
百度智能云VectorDB采用自研的性能测试工具ann-benchmark进行测试比对,该工具不依赖外部组件,并提供了官方的标准数据集和自制的数据集。本文详细介绍下基于ann-benchmark工具进行数据库性能测试的方法。
准备测试环境
- 下载测试工具。下载链接:linux-ann-benchmark-1.0.1.tar.gz
- 下载百度智能云VectorDB提供的数据集文件,下载链接见测试环境小节。
- 登录百度智能云BCC测试客户端环境(BCC的规格要求,请参见测试环境)。
- 执行
tar -zxvf linux-ann-benchmark-1.0.1.tar.gz命令解压测试工具压缩包。 - 下载数据集,并放在测试工具目录dataset文件夹下。
修改配置文件
进入测试工具目录,打开配置文件,配置相关参数
执行如下命令,拷贝配置文件,根据需要修改参数:
Shell
1vim conf/conf.toml样例配置文件的内容如下所示:
Shell
1logDir = "./log"
2
3# Config for ann benchmark dataset
4[Dataset]
5path = "./dataset"
6name = "SIFT_1M"
7
8# Config for vector store
9[VectorStore]
10name = "Mochow"
11endpoint = "http://*.*.*.*:*"
12user = "root"
13password = "********"
14database = "benchmark_db"
15table = "benchmark_table"
16dropExistingTable = true
17
18# Common Config for Test Case
19[TestCase]
20vectorIndex = "HNSW"
21# vectorIndex = "PUCK"
22topK = 10
23concurrency = [24, 36, 48]
24duration = 120
25recallRangeForQPSBench = [0.8, 0.995]
26
27###################################
28# Config for hnsw index build
29[TestCase.HNSW.Index]
30M = [16, 32]
31efConstruction = 200
32
33# Config for hnsw search
34[TestCase.HNSW.Search]
35ef = [20, 40, 60, 80, 100, 120, 140, 160, 180, 200, 400, 600, 800, 1000, 1200, 1400, 1600, 1800, 2000]
36
37###################################
38# Config for puck index build
39# [TestCase.PUCK.Index]
40# coarseclustercount = [50, 100]
41# fineclustercount = [50,100]
42
43# Config for puck search
44# [TestCase.PUCK.Search]
45# searchcoarsecount = [10, 20, 30, 40, 50, 60, 70, 80, 90, 100]
配置项参数含义如下:
| 配置项 | 参数含义 | 说明 |
|---|---|---|
| logDir | 测试工具日志目录 | ./log:工具根目录下的log目录 |
| Dataset.path | 测试数据集存放目录名 | ./dataset |
| Dataset.name | 数据集名称 | 支持如下几种:
|
| VectorStore.name | 向量数据库名称 | 支持如下两种:
|
| VectorStore.endpoint | 向量数据库的连接地址 | 获取向量数据库实例的内网IP地址与网络端口。可以在实例详情中的网络信息中查看,实际使用时建议添加协议前缀,目前支持http和https |
| VectorStore.user | 连接用户名 | 默认为root |
| VectorStore.password | 向量数据库的API访问密钥 | 如何获取,请参见 账号管理 |
| VectorStore.database | 测试使用的库名称 | 无 |
| VectorStore.table | 测试使用的表名称 | 无 |
| VectorStore.dropExistingTable | 是否删除并清空已存在的测试表 | TRUE |
| TestCase.vectorIndex | 向量索引类型 | 目前支持HNSW PUCK |
| TestCase.topK | 向量相似性检索最多返回的记录数 | 默认为10 |
| TestCase.concurrency | QPS测试Case中使用的并发数 | QPS测试中会依次尝试concurrency列表中不同的并发数 |
| TestCase.duration | QPS测试Case的持续时间,单位为秒 | 默认为120s |
| TestCase.recallRangeForQPSBench | QPS测试的召回率闭区间 | 在召回率范围内的测试集会进行QPS测试 |
| TestCase.HNSW.Index | 向量索引类型为HNSW的索引参数:
|
写入数据集后,会依次使用不同的M和efConstruction值构建索引测试召回率和QPS |
| TestCase.HNSW.Search.ef | 向量索引类型为HNSW的检索参数:
|
在进行召回率和QPS测试时,会依次尝试使用列表中的ef参数测试召回率和QPS。同一数据集,召回率越高,即ef参数设置越大时,QPS越低。在其他配置不变的情况下,若需提高召回率,可适当增加查询参数 ef |
| TestCase.PUCK.Index | PUCK向量索引类构建参数:
|
在写入数据集后,会依次使用不同的coarseclustercount和fineclustercount值构建索引测试召回率和QPS。PUCK内部多处使用了Kmeans算法,训练的特征向量上限设置为500万 |
| TestCase.PUCK.Search.searchcoarsecount | PUCK向量索引检索参数:
|
在进行召回率和QPS测试时,会依次尝试使用列表中的searchcoarsecount参数测试召回率和QPS。同一数据集,召回率越高,即searchcoarsecount参数设置越大时,QPS越低。在其他配置不变的情况下,若需提高召回率,可适当增加查询参数 searchcoarsecount |
运行测试工具
执行如下命令,运行测试工具。其中,-conf指明配置文件路径,配置文件中配置项的含义,请参见上一小节。
Shell
1cd linux-ann-benchmark-1.0.1
2./bin/ann-benchmark -conf ./conf/conf.toml
查看测试结果
测试结果
测试结束后,结果会写入到工具根目录的result/benchmark_result_{测试开始时间}格式文件中,内容样例如下:
Shell
1Mochow {M:16, efc:200} {ef:100} 82.76% 2431.7927其中每一行为一组测试参数下的测试结果,以空格分割开,每一部分的含义如下:
Mochow:本次测试采用的向量数据库类型;{M:16, efc:200}:向量索引的构建参数;{ef:100}:向量检索参数;82.76%:召回率;2431.7927:最大QPS;
实例状态
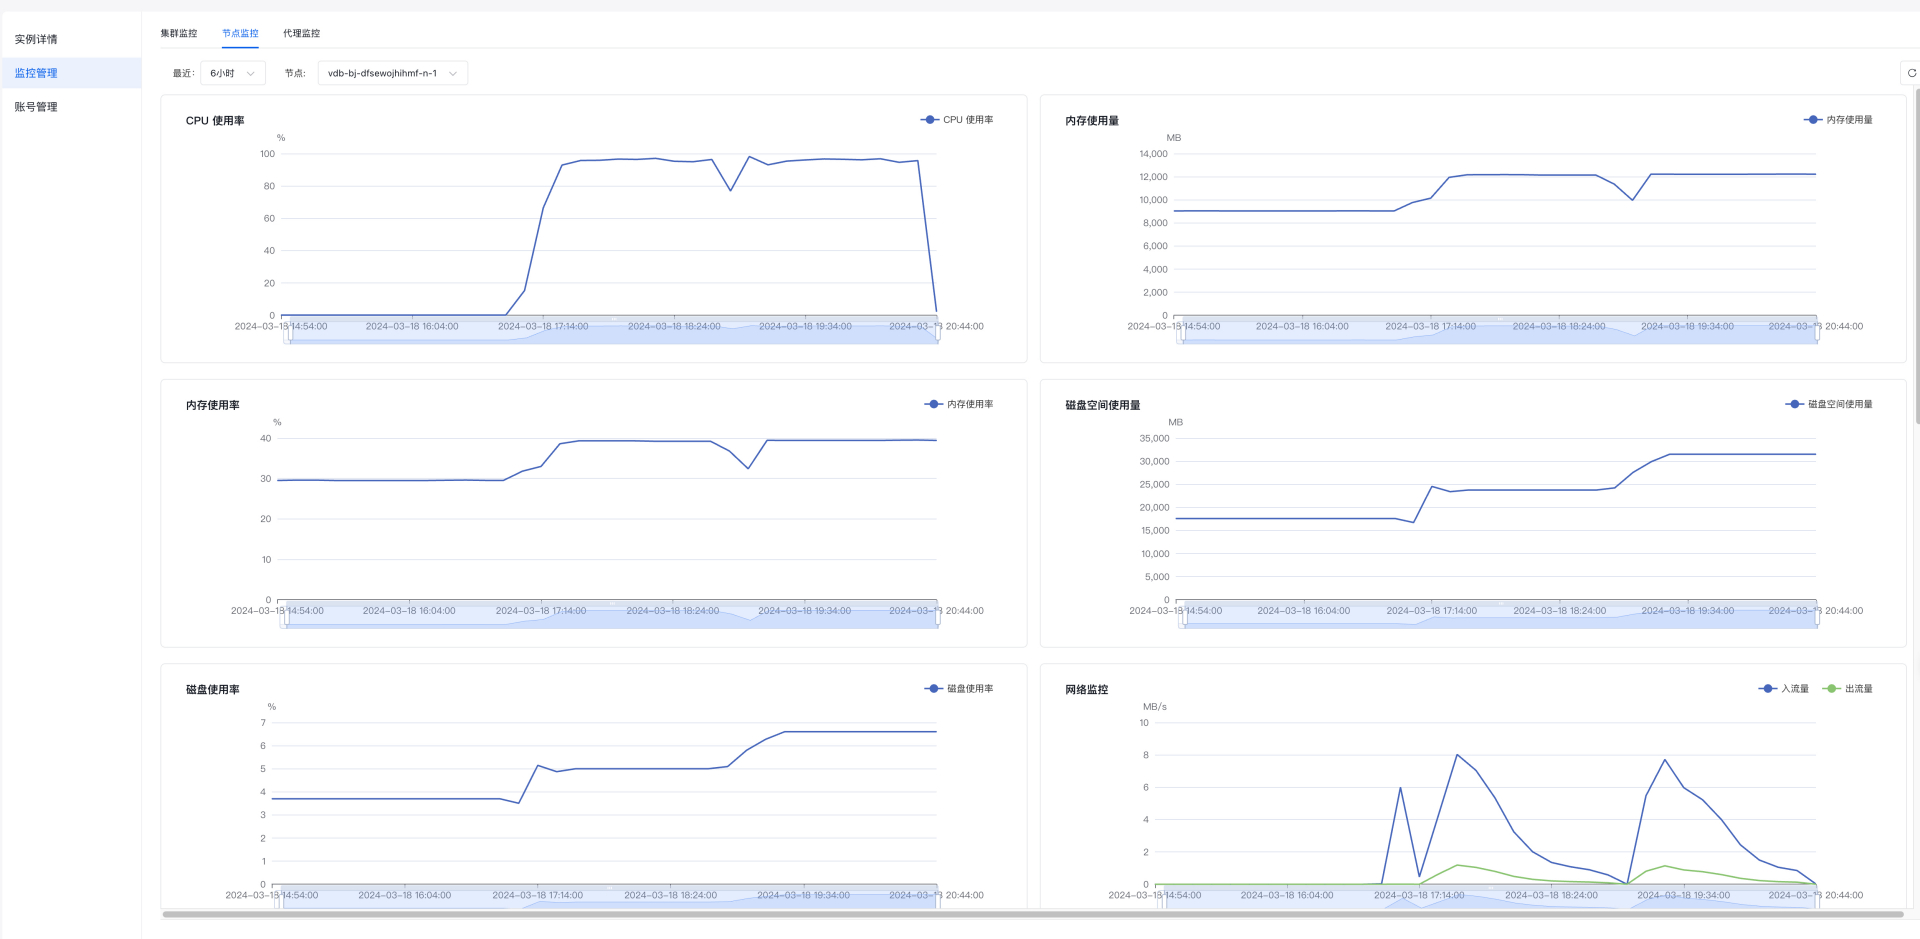
百度智能云VectorDB控制台提供了实例的CPU、内存、QPS、时延等关键性能指标监控,可以在测试过程中观察上述指标的状态,具体观察方法,请参见 查看监控数据。